🎙️ Протоколы совещаний из аудиозаписи

Загрузили запись — получили расшифровку по спикерам, оглавление по темам с таймкодами и черновик протокола

🎯 Проблема

После совещания кто-то должен разобрать запись и составить протокол:

  • Расшифровка вручную занимает часы: час совещания — это десятки страниц текста
  • Непонятно, кто что сказал: в записи несколько участников, а договорённости важно привязать к людям
  • Трудно найти нужное место: чтобы вспомнить обсуждение одной темы, приходится переслушивать всю запись
  • Записи нельзя отправлять в облако: внутренние совещания часто содержат конфиденциальную информацию

Результат: протоколы не ведутся или пишутся по памяти, решения и поручения теряются.

💡 Решение

Сервис, который сам расшифровывает запись, делит её на темы и готовит черновик протокола:

✅ Расшифровка по спикерам ✅ Оглавление по темам с таймкодами ✅ Черновик протокола от LLM ✅ Ручная правка текста ✅ Возможна полностью локальная работа

🔧 Как это работает

Этап Что происходит Результат
1. Подготовка аудио Запись приводится к единому формату, модель Silero VAD находит участки с речью и отбрасывает тишину Только фрагменты с речью
2. Спикеры Лёгкая модель WeSpeaker (ONNX, ~25 МБ) группирует фрагменты по голосам Кто и когда говорил
3. Распознавание Модель GigaAM v3 переводит русскую речь в текст; выбрана по итогам сравнения с вариантами Whisper Текст с таймкодами
4. Оглавление Соседние реплики объединяются по смыслу с помощью эмбеддингов (rubert-tiny2), LLM придумывает названия глав. Таймкоды берутся из распознавания — модель их не выдумывает Главы по темам
5. Протокол По кнопке LLM собирает черновик протокола встречи по тексту глав Черновик протокола
6. Проверка человеком В интерфейсе можно поправить текст реплики, спикера, имена участников и названия глав, вернуть исходную расшифровку Итоговый текст

💻 Пример интерфейса

1. Оглавление по темам
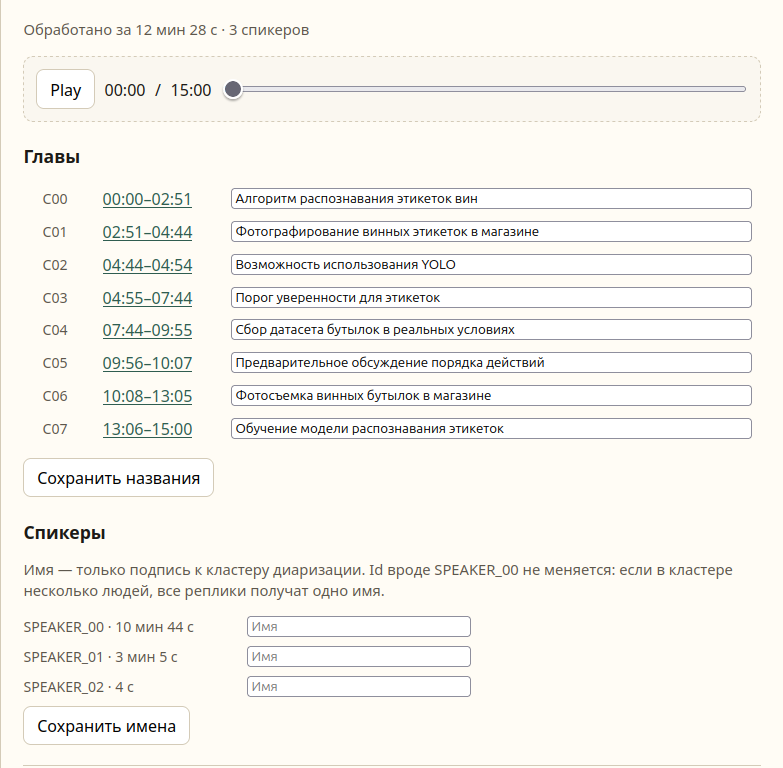
Оглавление записи

Главы с названиями и таймкодами, плеер и время речи каждого спикера

2. Текст главы
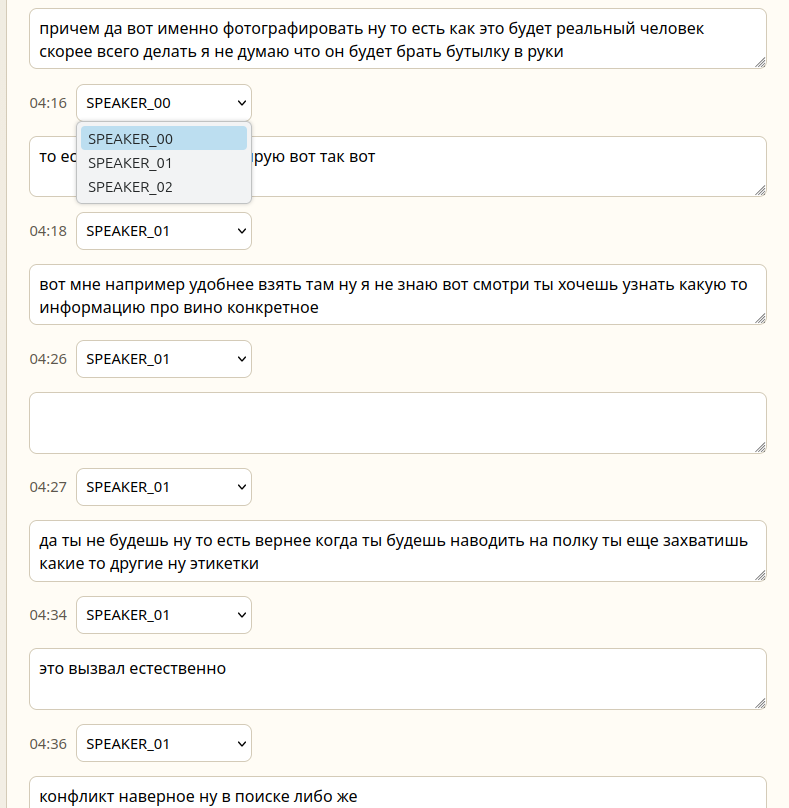
Текст главы

Реплики по спикерам с возможностью правки

3. Протокол встречи
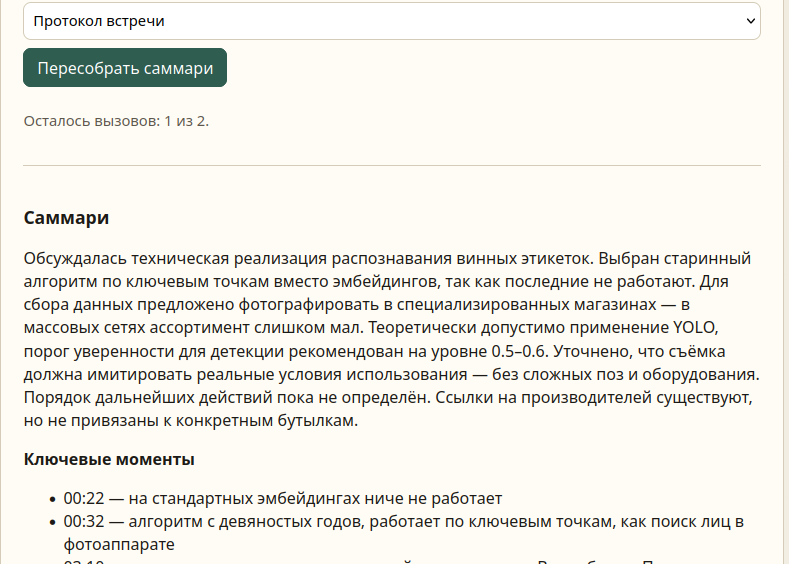
Протокол встречи

Черновик протокола, собранный LLM по тексту глав

✨ Ключевые преимущества

  • Подходит для конфиденциальных встреч — возможна полностью локальная обработка: распознавание, спикеры и оглавление работают на сервере заказчика, LLM тоже может быть локальной
  • Работает без GPU — весь стек подобран так, чтобы запускаться на обычном сервере
  • Модели выбраны по замерам — сравнивались несколько вариантов распознавания, определения речи и спикеров; в работу взяты самые точные и лёгкие
  • Честные таймкоды — время глав берётся из распознавания, LLM пишет только названия и протокол
  • Человек в контуре — протокол помечен как черновик, текст и спикеров можно поправить, исходная расшифровка сохраняется

📈 Метрики

Показатель Значение
Ошибки распознавания GigaAM относительно Whisper на 15% меньше
Отправка данных во внешние сервисы не обязательна (полностью локальный режим)
💡 Как сравнивали: несколько моделей распознавания прогнали на одних и тех же записях совещаний с ручной расшифровкой и посчитали долю ошибочных слов (WER). У GigaAM ошибок на 15% меньше, чем у лучшего из протестированных вариантов Whisper.
💡 Статус проекта: тестовое задание. На сервере развёрнуто урезанное демо: ограничена длина записи и число запросов протокола.

🚀 Варианты улучшения

Направление Что добавить
Словарь терминов Исправление отраслевых слов после распознавания с предложением добавить замену в словарь
Подсветка сомнительных слов Выделение мест с низкой уверенностью распознавания для быстрой проверки
Локальная LLM Протокол без внешних API для полностью закрытого контура
Длинные записи Совещания на час и больше в боевом режиме
Экспорт Выгрузка протокола в Markdown / PDF

🛠️ Технологии

Python FastAPI Jinja2 ffmpeg Silero VAD WeSpeaker ONNX GigaAM rubert-tiny2 Qwen LLM API Docker

🔗 Ссылки

🚀 Открыть демо @ Написать в Telegram

Нужна расшифровка и протоколы совещаний в закрытом контуре? Напишите мне — обсудим адаптацию под ваши задачи.